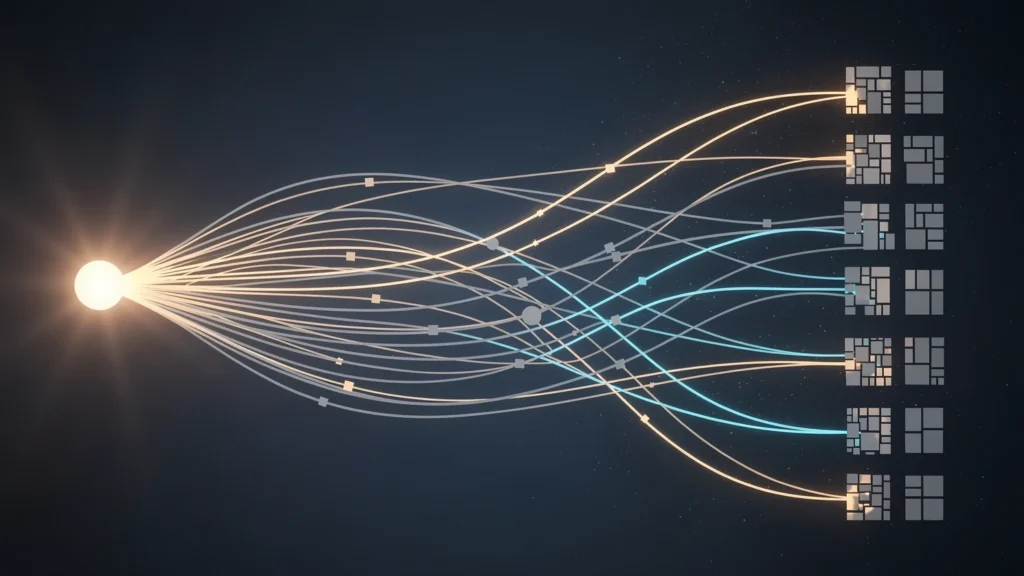
Google Research opublikował framework, który może przebudować najdroższy element wyszukiwania AI: rozbijanie jednego zapytania użytkownika na dziesiątki zapytań pobocznych. Nowa metoda, nazwana R4T-Diffusion, zastępuje duży model językowy lekką siecią dyfuzyjną o 53,9 mln parametrów i skraca czas generowania całego wachlarza zapytań z około 50 sekund do 4,21 sekundy. Dla branży SEO to pierwszy publiczny wgląd w to, jak Google zamierza obniżyć koszt query fan-outu, mechanizmu, który decyduje o tym, czyje treści trafiają do odpowiedzi AI.
O pracy szerzej napisał serwis Search Engine Journal 24 września 2026, a wcześniej opisał ją MarkTechPost. Sam artykuł naukowy trafił na arXiv już 6 marca 2026, co oznacza, że między publikacją badania a nagłością tematu minęło ponad pół roku. To luka, którą część analityków czyta jako sygnał, że technologia zdążyła już opuścić laboratorium.
Kontekst: dlaczego query fan-out jest wąskim gardłem AI search
Kiedy wpisujesz zapytanie w AI Mode albo w ChatGPT z dostępem do sieci, silnik nie szuka dokładnie tego, co napisałeś. Najpierw rozkłada intencję na zbiór podzapytań, potem zbiera wyniki dla każdego z nich i dopiero z tego materiału buduje odpowiedź. Ten etap nazywa się query fan-out i opisywaliśmy go szczegółowo w przewodniku po działaniu Google AI Mode. Z perspektywy SEO to najważniejszy moment całego procesu: jeśli Twoja strona nie odpowiada na żadne z wygenerowanych podzapytań, nie pojawi się w odpowiedzi, niezależnie od tego, jak dobrze rankuje na frazę główną.
Problem jest arytmetyczny. Żeby wygenerować dziesięć sensownych, różnych od siebie podzapytań, trzeba uruchomić model językowy, który produkuje je token po tokenie. Przy jednym użytkowniku to ułamek sekundy. Przy milionach zapytań dziennie, gdy serwery przetwarzają zadania w dużych paczkach, opóźnienie rośnie do poziomu, którego nie da się ukryć przed użytkownikiem. Autorzy pracy podają konkretną liczbę: przy wielkości batcha 1024 klasyczne, autoregresyjne generowanie wachlarza zapytań zajmuje około 50 sekund.
Do tego dochodzi problem jakości. Zbiór podzapytań ma spełniać warunki, których nie da się ocenić na poziomie pojedynczego elementu: ma być różny wewnętrznie, ma pokrywać temat i ma trzymać się oryginalnej intencji. W języku badaczy to cele zbiorowe, niedekomponowalne. Klasyczne zbiory treningowe typu zapytanie plus treść premiują tylko jeden najlepszy wynik, więc nie uczą modelu, jak zbudować dobry zestaw. Autorzy nazywają to wprost luką w dostępnych danych nadzorowanych, i właśnie ta luka jest punktem wyjścia dla całej konstrukcji.
Dotychczasowe obejście polegało na uczeniu ze wzmocnieniem. Model można trenować tak, żeby optymalizował nagrodę liczoną dla całego zbioru, bo w uczeniu ze wzmocnieniem nagroda nie musi rozkładać się na pojedyncze elementy. Kłopot w tym, że model językowy dostrojony metodą RL jest równie kosztowny w chwili odpowiadania jak każdy inny duży model. Zysk jakościowy pojawia się tam, gdzie budżet obliczeniowy jest najbardziej napięty.
Kluczowe fakty: co dokładnie zrobili badacze
Praca nosi tytuł „Efficient, Property-Aligned Fan-Out Retrieval via RL-Compiled Diffusion” i jest sygnowana przez zespół, w którym obok Pengcheng Jianga i Judith Yue Li znajduje się Craig Boutilier, jedno z bardziej rozpoznawalnych nazwisk w badaniach nad systemami rekomendacyjnymi w Google. Identyfikator arXiv to 2603.06397.
Mechanizm ma trzy etapy i właśnie kolejność jest tu sednem pomysłu. Uczenie ze wzmocnieniem, czyli najdroższy element, uruchamiane jest raz, offline, i służy tylko do przetłumaczenia celów zbiorowych na dane treningowe. Badacze używają na to określenia „przetwornik celu” (objective transducer). Następnie z wytrenowanego modelu zbiera się przykłady dobrych wachlarzy zapytań. Na koniec te przykłady służą do wytrenowania małego modelu dyfuzyjnego, który produkuje cały zbiór kierunków wyszukiwania w jednym przejściu, w przestrzeni wektorowej, bez generowania tekstu token po tokenie.
Trzy etapy R4T
- Etap 1: trening modelu językowego generującego wachlarz zapytań, z nagrodą liczoną na poziomie całego zbioru, a nie pojedynczego zapytania.
- Etap 2: synteza spójnych z celem par treningowych. Badacze próbkowali 128 wachlarzy na zapytanie przy temperaturze 0,9.
- Etap 3: trening lekkiego retrievera dyfuzyjnego (53,9 mln parametrów), który modeluje warunkowy rozkład całych zbiorów wyników.
Funkcja nagrody opiera się na trzech filarach z przypisanymi wagami. Ugruntowanie (groundedness), czyli pewność, że podzapytanie faktycznie da się znaleźć w bazie, waży 0,6. Różnorodność, mierzona wskaźnikiem Vendi Score, waży 0,2. Zgodność z pierwotnym zapytaniem (alignment) również 0,2. Trening prowadzono algorytmem GRPO z miękką regularyzacją PPO, przy rozmiarze grupy 8, globalnym batchu 512 i współczynniku uczenia 1×10 do potęgi minus siedem. Każde zapytanie rozbijano na dziesięć podzapytań, a metoda porównawcza best-of-N korzystała z pięciu prób.
Wyniki pomiarów
| Metryka | Podejście autoregresyjne | R4T-Diffusion |
|---|---|---|
| Czas generowania wachlarza, batch 8 | ok. 1,46 s | 0,07 s |
| Czas generowania wachlarza, batch 1024 | ok. 50 s | 4,21 s |
| Deklarowane przyspieszenie | punkt odniesienia | 12x do 20x |
| Testowane modele | Gemma3-4B, Qwen3-4B, Gemini 2.5 Flash | 53,9 mln parametrów |
| Vendi Score (Polyvore, WSCR) | 27,5 dla wariantu językowego | 34,7 |
Jakość sprawdzano na dwóch zbiorach: modowym Polyvore i muzycznym, obu złożonych z kuratorowanych zestawów produktów lub utworów. W zadaniu otwartego wyszukiwania abstrakcyjnego wariant R4T na bazie Gemma3-4B osiągnął średni wynik 49,1 przy 40,9 dla metody best-of-N i 38,5 dla modelu bez treningu. Na zbiorze muzycznym różnica była większa: 58,1 wobec 49,2. W metryce różnorodności model bazowy notował 56,0, wariant językowy 76,8, a wersja dyfuzyjna 74,3, czyli niemal całą przewagę udało się przenieść do małego modelu.
W drugim zadaniu, słabo nadzorowanym wyszukiwaniu kompozycyjnym, wariant R4T na Qwenie osiągnął Recall@5K na poziomie 20,9 i Hit@5K 64,6, podczas gdy Gemini 2.5 Flash zatrzymało się na 15,7 i 52,1. Wersja dyfuzyjna miała niższy Recall@5K (16,5), ale najwyższy Vendi Score w całym zestawieniu: 34,7. To ważny niuans, o którym łatwo zapomnieć przy nagłówkach mówiących o dwudziestokrotnym przyspieszeniu. Mały model nie jest lepszy od dużego na każdej metryce. Jest porównywalny przy drastycznie niższym koszcie i wyraźnie bardziej różnorodny.
Co to znaczy dla SEO i AIO
Najważniejsza konsekwencja jest ekonomiczna, nie algorytmiczna. Jeśli generowanie wachlarza zapytań tanieje o rząd wielkości, to znika główny powód, dla którego silnik AI ogranicza liczbę podzapytań. Dzisiejszy limit dziesięciu kierunków nie jest prawem natury, tylko kompromisem kosztowym. Przy koszcie niższym dwudziestokrotnie ten sam budżet obliczeniowy kupuje znacznie szerszy wachlarz.
Dla widoczności w odpowiedziach AI to zmienia rachunek w dwie strony jednocześnie. Szerszy fan-out oznacza więcej nisz, w których można zostać zauważonym, bo silnik zaczyna pytać także o wątki poboczne, których przy dziesięciu podzapytaniach nigdy nie dotykał. Jednocześnie oznacza to większą konkurencję na każdym pojedynczym podzapytaniu i mniejszy udział pojedynczego źródła w gotowej odpowiedzi. Mechanizm doboru linków w odpowiedziach modelu opisywaliśmy przy okazji analizy tego, jak Gemini dobiera źródła, i ta logika nie zmienia się wraz z R4T. Zmienia się tylko liczba drzwi, do których model puka.
Drugi wniosek dotyczy tego, za co nagradzany jest model generujący podzapytania. Waga 0,6 przy ugruntowaniu to sygnał, że system jest wprost karany za wymyślanie zapytań, na które nie ma odpowiedzi w indeksie. W praktyce premiuje to treści, które odpowiadają na pytania sformułowane w języku faktycznie występującym w dokumentach, a nie na abstrakcyjne trawersy tematyczne. Waga 0,2 przy różnorodności mówi z kolei, że silnikowi zależy na pokryciu różnych aspektów tematu, co działa na korzyść stron obsługujących wąski, dobrze zdefiniowany wycinek problemu.
Trzeci wniosek jest metodologiczny i dotyczy raportowania. Jeżeli liczba podzapytań na jedno zapytanie użytkownika rośnie, to rośnie też liczba wyświetleń, przy których Twoja strona bierze udział w konkursie, ale niekoniecznie liczba cytowań. Wskaźnik typu udział w odpowiedziach może spaść bez żadnej zmiany na Twojej stronie, wyłącznie dlatego, że mianownik się poszerzył. Przy comiesięcznym raportowaniu warto mieć na to gotowe wyjaśnienie zanim klient zapyta.
Praktyczne wnioski
- Optymalizuj pod zbiory pytań pobocznych, nie pod jedną frazę główną. Jeśli artykuł odpowiada tylko na temat nagłówka, przy szerszym fan-oucie nie zyskuje nic.
- Pisz językiem, który da się odzyskać z indeksu. Nagroda za ugruntowanie premiuje dopasowanie do realnie istniejących sformułowań, nie do kreatywnych parafraz.
- Traktuj różnorodność jako szansę. Strona pokrywająca odrębny aspekt tematu wygrywa z kolejnym ogólnym przewodnikiem, bo silnik szuka komplementarności, nie powtórzeń.
- Nie zakładaj stabilności pomiarów. Jeśli liczba podzapytań wzrośnie, Twoje udziały w cytowaniach mogą spaść przy niezmienionej jakości treści.
- Rozdziel w raportach wyświetlenia od cytowań. To dwie różne wielkości i przy szerszym fan-oucie rozjadą się jeszcze mocniej.
Reakcje branży
Ton komentarzy jest ostrożny, a linia podziału przebiega wokół jednego pytania: czy R4T-Diffusion działa już w produkcyjnym wyszukiwaniu Google. Search Engine Journal zwraca uwagę na sześciomiesięczną lukę między publikacją na arXiv a szerszym komunikatem i formułuje hipotezę, że framework mógłby wyjaśniać obserwowane w ostatnich miesiącach zmiany w ruchu oraz w liczbie linków widocznych w AI Mode. Serwis wprost zaznacza jednak, że wdrożenie nie zostało potwierdzone. W materiałach towarzyszących pracy pojawiają się sformułowania o rozbiciu wąskiego gardła opóźnień i o gotowej do produkcji, eksperckiej jakości wyszukiwania, ale to język opisu wyników laboratoryjnych, nie komunikat o wdrożeniu.
Tu warto zachować dyscyplinę. Praca naukowa jest walidowana na zbiorach modowych i muzycznych, a wśród deklarowanych zastosowań autorzy wymieniają systemy rekomendacyjne w rodzaju Google Discover i rekomendacji YouTube, planowanie oraz generowanie kreatywne. Wyszukiwanie tekstowe nie jest w tym zestawieniu wymienione jako zweryfikowany przypadek użycia. Przenoszenie wyników z rekomendacji produktowych na organiczne wyniki wyszukiwania jest ekstrapolacją, nie odczytem z badania.
Sami autorzy dorzucają zastrzeżenie, które rzadko trafia do nagłówków: wdrożenie w kontekstach wrażliwych wymaga audytów uprzedzeń specyficznych dla domeny. Model dyfuzyjny wytrenowany na wachlarzach wygenerowanych przez większy model dziedziczy jego skłonności, a przy 53,9 mln parametrów ma mniej pojemności na ich korygowanie. W praktyce oznacza to, że tańszy retrieval nie jest neutralny: przenosi uprzedzenia nauczyciela do systemu, który obsługuje znacznie większy wolumen.
Cała sprawa wpisuje się zresztą w szerszy wzorzec z ostatnich tygodni. Google publikuje coraz więcej szczegółów o infrastrukturze stojącej za wyszukiwaniem AI, od agentowego systemu SAFE do wykrywania AI slopu po prace nad tańszym retrievalem. Wspólny mianownik jest jeden: obniżanie kosztu jednostkowego odpowiedzi generowanej przez model. Każdy taki krok zwiększa liczbę zapytań, które opłaca się obsłużyć trybem konwersacyjnym zamiast klasyczną listą wyników.
Co dalej
W najbliższych tygodniach warto śledzić trzy rzeczy. Pierwsza to oficjalna komunikacja Google na temat wdrożenia. Dopóki firma nie potwierdzi, że R4T-Diffusion obsługuje produkcyjny ruch w Search, każda korelacja ze spadkami ruchu pozostaje domysłem. Druga to liczba źródeł cytowanych w odpowiedziach AI Mode. Jeśli fan-out faktycznie się rozszerza, powinno to być widoczne jako wzrost liczby unikalnych domen na odpowiedź przy jednoczesnym spadku udziału lidera.
Trzecia rzecz jest najbardziej praktyczna: własne dane. Zamiast czekać na potwierdzenie, warto zbudować własny panel kontrolny, obejmujący stały zestaw zapytań i regularny zapis tego, które strony pojawiają się w odpowiedziach. Różnica między realną zmianą algorytmu a przypadkowym wahaniem jest widoczna wyłącznie w szeregu czasowym, nigdy w jednorazowym zrzucie ekranu. Kluczowe słowo to „stały”: panel zbudowany na zapytaniach dobieranych za każdym razem od nowa mierzy własną zmienność, nie zmianę silnika. Różnice między samymi formatami odpowiedzi opisywaliśmy w porównaniu AI Overviews i AI Mode, i to nadal dobry punkt startowy przy ustalaniu, co właściwie mierzysz.
Dla zespołów SEO wniosek na dziś jest umiarkowany. R4T-Diffusion nie jest aktualizacją algorytmu, na którą reaguje się w tym tygodniu. Jest zapowiedzią kierunku: wyszukiwanie AI będzie zadawać więcej pytań, taniej, i będzie to robić modelami premiującymi ugruntowanie oraz różnorodność. Treści zbudowane na weryfikowalnych faktach i pokrywające konkretny, odrębny wycinek tematu zyskają w tym układzie więcej niż ogólne przewodniki napisane pod jedną frazę. To nie jest nowa rekomendacja, ale po raz pierwszy mamy opublikowaną funkcję nagrody, która pokazuje, dlaczego właśnie ta dwójka kryteriów jest premiowana.
FAQ
Czym jest query fan-out w wyszukiwaniu AI?
To etap, w którym silnik rozkłada jedno zapytanie użytkownika na zbiór podzapytań, zbiera wyniki dla każdego z nich i dopiero z tego materiału buduje odpowiedź. W pracy Google każde zapytanie rozbijano na dziesięć podzapytań. Z perspektywy widoczności to moment krytyczny: strona, która nie odpowiada na żadne z wygenerowanych podzapytań, nie trafia do odpowiedzi.
Czy R4T-Diffusion działa już w wyszukiwarce Google?
Nie zostało to potwierdzone. Praca trafiła na arXiv 6 marca 2026, a szerszą uwagę zyskała we wrześniu 2026, co część analityków czyta jako sygnał wdrożenia, ale to hipoteza. Badanie walidowano na zbiorach modowych i muzycznych, a autorzy wymieniają systemy rekomendacyjne jako zastosowanie docelowe, nie wyszukiwanie tekstowe.
O ile szybszy jest model dyfuzyjny od klasycznego podejścia?
Autorzy deklarują przyspieszenie 12x do 20x. W liczbach bezwzględnych: przy wielkości batcha 1024 podejście autoregresyjne potrzebuje około 50 sekund, a model dyfuzyjny 4,21 sekundy. Przy batchu 8 to odpowiednio około 1,46 sekundy i 0,07 sekundy.
Co oznacza wysoka waga ugruntowania w funkcji nagrody?
Ugruntowanie waży 0,6 z trzech kryteriów, przy 0,2 dla różnorodności i 0,2 dla zgodności z pierwotnym zapytaniem. Oznacza to, że system jest karany za generowanie podzapytań, na które nie ma odpowiedzi w bazie. W praktyce premiuje treści używające sformułowań realnie występujących w dokumentach, a nie kreatywnych parafraz.
Jak przygotować stronę na szerszy fan-out?
Zamiast optymalizować pod jedną frazę główną, warto pokryć zbiór pytań pobocznych wokół tematu, używać języka dającego się odzyskać z indeksu i celować w odrębny, dobrze zdefiniowany wycinek problemu. Silnik szuka komplementarności między źródłami, więc kolejny ogólny przewodnik ma mniejsze szanse niż tekst pokrywający aspekt pominięty przez konkurencję.