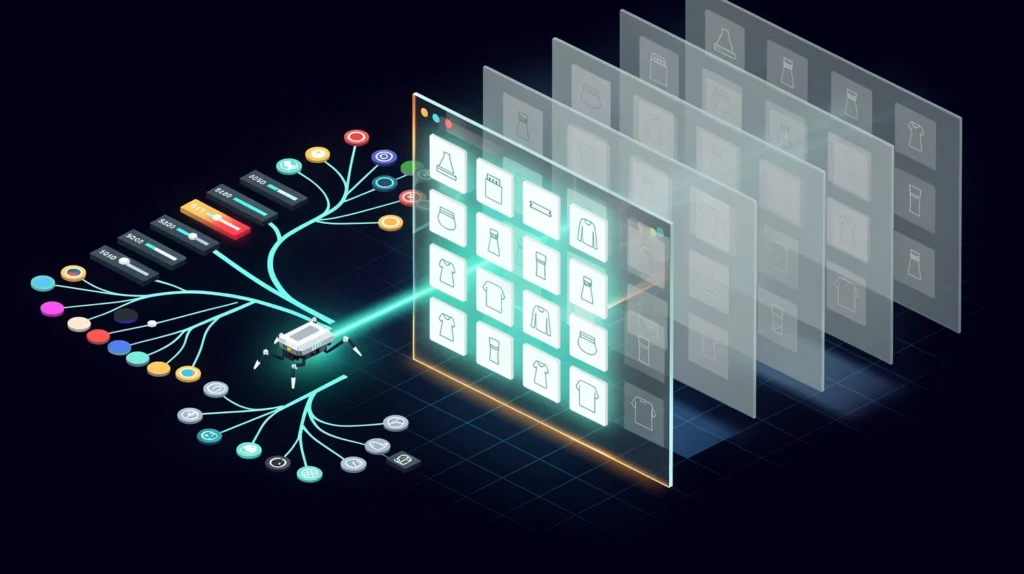
Filtry to jedno z najwygodniejszych narzędzi w sklepie internetowym i jednocześnie jedna z najczęstszych przyczyn problemów z indeksacją. Każde kliknięcie w kolor, rozmiar czy przedział cenowy może tworzyć nowy adres URL. W sklepie z kilkoma tysiącami produktów daje to setki tysięcy wariantów, z których tylko niewielka część odpowiada temu, czego ludzie faktycznie szukają. Nawigacja fasetowa w SEO sprowadza się więc do jednej decyzji: które kombinacje otworzyć dla Google i modeli AI, a które przed nimi schować.
Ten tekst rozwija wątek filtrów z naszego przewodnika po przygotowaniu sklepu pod AI: feed, opisy i kategorie. Skupiamy się na praktyce: jak wybrać faset warty indeksacji, jak go oznaczyć i co zrobić z resztą.
Jak powstają setki adresów z filtrów
Typowa strona kategorii ma kilka grup filtrów: marka, rozmiar, kolor, materiał, cena, dostępność, sortowanie. Jeśli każda wartość dopisuje parametr do adresu, liczba kombinacji rośnie wykładniczo. Kategoria „buty do biegania” z 10 markami, 15 rozmiarami, 8 kolorami i 4 opcjami sortowania to już 4800 adresów przy wyborze jednej wartości z każdej grupy. Gdy sklep pozwala zaznaczać kilka wartości naraz, liczba robi się praktycznie nieograniczona.
Problem pogłębia kolejność parametrów. Adres ?kolor=czarny&rozmiar=42 i ?rozmiar=42&kolor=czarny pokazują identyczną listę, ale dla robota to dwa osobne dokumenty. Do tego dochodzą parametry sesji, śledzenia kampanii i paginacja. Efekt widać w Search Console: tysiące stron w statusie „Strona zeskanowana, ale obecnie niezindeksowana” albo „Duplikat, użytkownik nie wybrał strony kanonicznej”.
Dlaczego to w ogóle przeszkadza
Googlebot ma ograniczony czas na każdy serwis. Jeśli spędza go na przeglądaniu wariantów sortowania, rzadziej wraca do nowych produktów i ważnych kategorii. Google wprost opisuje to w dokumentacji o zarządzaniu nawigacją fasetową, wskazując ją jako jedno z głównych źródeł nadmiernego crawlowania. Drugi koszt to rozproszenie sygnałów: linki i zachowania użytkowników rozkładają się na dziesiątki niemal identycznych adresów zamiast wzmacniać jeden.
Które kombinacje mają realny popyt
Zasada jest prosta: indeksujemy tylko te strony filtrowane, które odpowiadają frazom wpisywanym w wyszukiwarkę lub pytaniom zadawanym asystentom AI. Reszta służy wyłącznie wygodzie użytkownika na stronie.
W praktyce popyt mają zwykle cztery typy fasetów:
- Marka w kategorii, np. „buty do biegania Asics”. To najczęściej najmocniejszy faset w sklepach wielomarkowych.
- Typ lub przeznaczenie, np. „buty do biegania w terenie”, „plecak na laptopa 15 cali”.
- Cecha kluczowa dla decyzji, np. „kurtka wodoodporna damska”, „odkurzacz bezprzewodowy z mopem”.
- Płeć lub grupa docelowa, jeśli nie jest już osobną kategorią.
Popytu zwykle nie mają: sortowanie, przedziały cenowe, dostępność, liczba produktów na stronie, kombinacje trzech i więcej filtrów oraz większość kolorów (wyjątkiem bywa moda, gdzie „czarna sukienka” to realna fraza). Weryfikację najlepiej zrobić na danych: lista fraz z narzędzia do badania słów kluczowych, raport zapytań z Search Console i wyszukiwarka wewnętrzna sklepu. Jeżeli kombinacja nie ma choćby kilkudziesięciu wyszukiwań miesięcznie, nie warto budować dla niej osobnej strony.
Prosta matryca decyzyjna
| Rodzaj filtra | Popyt w wyszukiwarce | Rekomendacja |
|---|---|---|
| Marka w kategorii | Wysoki | Indeksować, statyczny URL, własny opis |
| Typ, przeznaczenie | Średni lub wysoki | Indeksować wybrane, często jako podkategorie |
| Rozmiar, kolor | Niski (poza modą) | Zwykle nie indeksować |
| Cena, sortowanie, dostępność | Brak | Blokować crawl lub nie generować linków |
| Kombinacje 3+ filtrów | Brak | Blokować crawl |
Kanoniczne adresy i parametry
Wybrane fasety powinny dostać czyste, stałe adresy, najlepiej w ścieżce: /buty-do-biegania/asics zamiast /buty-do-biegania?marka=12. Taki adres ma stały tytuł, nagłówek H1 i opis, a sklep linkuje do niego z menu, kategorii nadrzędnej i kart produktów.
Pozostałe warianty dostają rel="canonical" wskazujący na stronę kategorii lub najbliższy indeksowany faset. Trzeba jednak pamiętać, że canonical jest dla Google wskazówką, a nie poleceniem. Wyszukiwarka zignoruje go, gdy treść strony filtrowanej wyraźnie różni się od wskazanego adresu. Dlatego canonical z „kurtek czerwonych w rozmiarze S” na ogólną kategorię „kurtki” działa słabo: lista produktów jest zupełnie inna. Szczegóły tego mechanizmu Google opisuje w poradniku o konsolidacji zduplikowanych adresów.
Kilka zasad technicznych, które oszczędzają kłopotów:
- Stała kolejność parametrów generowana przez silnik sklepu (np. alfabetyczna).
- Brak pustych parametrów i duplikatów wartości w adresie.
- Filtry bez wartości SEO ładowane bez zmiany adresu albo przez parametr po znaku
#, którego robot nie traktuje jako osobnej strony. - Mapa witryny zawiera wyłącznie indeksowane fasety, nigdy adresy z parametrami.
Blokada w robots.txt kontra noindex
To najczęściej mylone narzędzia. Oba ograniczają obecność stron filtrowanych w wynikach, ale działają na różnych etapach.
Disallow w robots.txt zatrzymuje robota przed pobraniem strony. Oszczędza budżet crawlowania, ale robot nie widzi wtedy ani treści, ani znacznika canonical, ani noindex. Adres może nadal trafić do indeksu bez opisu, jeśli prowadzi do niego dużo linków. To dobre rozwiązanie dla sortowania, cen i kombinacji wielu filtrów, czyli wszędzie tam, gdzie chodzi o skalę.
Meta robots noindex wymaga, żeby robot stronę pobrał. Usuwa ją z indeksu, ale nie zmniejsza liczby żądań. Sprawdza się przy wariantach, których jest niewiele, a które z jakiegoś powodu muszą pozostać dostępne.
Najgorsze połączenie to oba naraz: strona zablokowana w robots.txt z noindex w kodzie. Robot nigdy nie zobaczy noindex, więc nie usunie adresu z indeksu. Jeśli chcesz wyczyścić indeks z fasetów, najpierw zostaw je otwarte z noindex, poczekaj na ponowne pobranie, a dopiero potem dodaj Disallow.
Opisy na stronach filtrowanych
Faset otwarty do indeksacji bez własnej treści to w oczach Google kolejna lista produktów. Szanse rosną, gdy strona dostaje unikalny tytuł, H1 z frazą, 80–150 słów wstępu nad listą i krótki fragment poradnikowy pod nią. Dla „butów do biegania Asics” to może być informacja, które modele nadają się na asfalt, a które w teren, oraz czym różnią się linie Gel i Novablast.
Ten sam fragment jest materiałem dla modeli językowych. Asystent AI, który odpowiada na pytanie „jakie buty Asics do biegania po asfalcie”, szuka zdań zawierających konkretne fakty, a nie samej siatki produktów. Więcej o budowie takich opisów piszemy w tekście o kategoriach e-commerce w AI. Opisy nie muszą powstawać ręcznie dla wszystkich fasetów naraz: zacznij od 20–30 kombinacji z największym popytem i rozszerzaj listę na podstawie danych.
Wpływ na crawl botów AI
Boty modeli językowych radzą sobie z fasetami gorzej niż Googlebot. Nie mają dojrzałych mechanizmów deduplikacji adresów, często ignorują canonical i potrafią w krótkim czasie wysłać dziesiątki tysięcy żądań do wariantów filtrów. Na hostingu bez cache to realne obciążenie serwera, a dla sklepu zero korzyści, bo żaden asystent nie zacytuje strony „sortuj po cenie rosnąco”.
Dlatego reguły Disallow dla parametrów filtrów warto stosować dla wszystkich robotów, nie tylko dla Googlebota. Jednocześnie nie należy blokować botów AI w całości, jeśli sklepowi zależy na widoczności w odpowiedziach ChatGPT czy Perplexity. Gotowe zestawy reguł dla sklepu znajdziesz w artykule robots.txt i boty AI: co blokować, a co wpuszczać. Indeksowane fasety z czystymi adresami i opisami to z kolei dokładnie te strony, które modele chętnie przywołują przy pytaniach zakupowych, podobnie jak oferty widoczne w Google Shopping i AI Overviews.
Całość warto osadzić w szerszej strategii widoczności w wyszukiwarkach generatywnych, którą opisujemy w frameworku SEO pod AI dla agencji. Nawigacja fasetowa jest jednym z jego technicznych fundamentów: decyduje, które strony sklepu w ogóle mają szansę stać się źródłem odpowiedzi.
FAQ
Czy wszystkie filtry w sklepie powinny być zablokowane dla Google?
Nie. Fasety odpowiadające realnym zapytaniom, najczęściej marka w kategorii albo przeznaczenie produktu, warto udostępnić z czystym adresem i opisem. Blokować należy sortowanie, przedziały cenowe i kombinacje wielu filtrów, które nie mają popytu.
Co wybrać dla stron filtrowanych: robots.txt czy noindex?
Robots.txt, gdy problemem jest skala i budżet crawlowania. Noindex, gdy wariantów jest niewiele i muszą być dostępne. Nie łącz obu na tym samym adresie, bo robot zablokowany w robots.txt nie zobaczy znacznika noindex.
Czy canonical wystarczy, żeby uporządkować filtry?
Rzadko. Canonical jest wskazówką i Google ignoruje go, gdy strona filtrowana zbyt mocno różni się od adresu kanonicznego. Działa dobrze przy wariantach sortowania lub kolejności parametrów, słabo przy filtrach zmieniających listę produktów.
Ile stron fasetowych warto zaindeksować na start?
Zwykle 20–30 kombinacji z największym popytem w danych z narzędzi do słów kluczowych i Search Console. Każda powinna mieć unikalny tytuł, nagłówek i krótki opis. Listę rozszerzaj dopiero po sprawdzeniu, czy pierwsze strony zbierają wyświetlenia.
Czy boty AI respektują reguły robots.txt dla filtrów?
Główne boty, takie jak GPTBot, OAI-SearchBot czy PerplexityBot, deklarują przestrzeganie robots.txt. Reguły Disallow dla parametrów filtrów warto więc pisać dla wszystkich agentów, a skuteczność sprawdzać w logach serwera.